[Inżynieria danych]

Twój fundament danych - niezawodny, wydajny i gotowy na AI

Zbieramy, porządkujemy i łączymy Twoje dane, żeby mogli z nich łatwo korzystać Twoi pracownicy, Twoje narzędzia biznesowe i modele AI.
+200 pipeline'ów danych na produkcji u naszych klientów
Średnio o 80% mniej ręcznej konsolidacji danych
140+ seniorskich specjalistów tech po École Polytechnique, Centrale i ENS
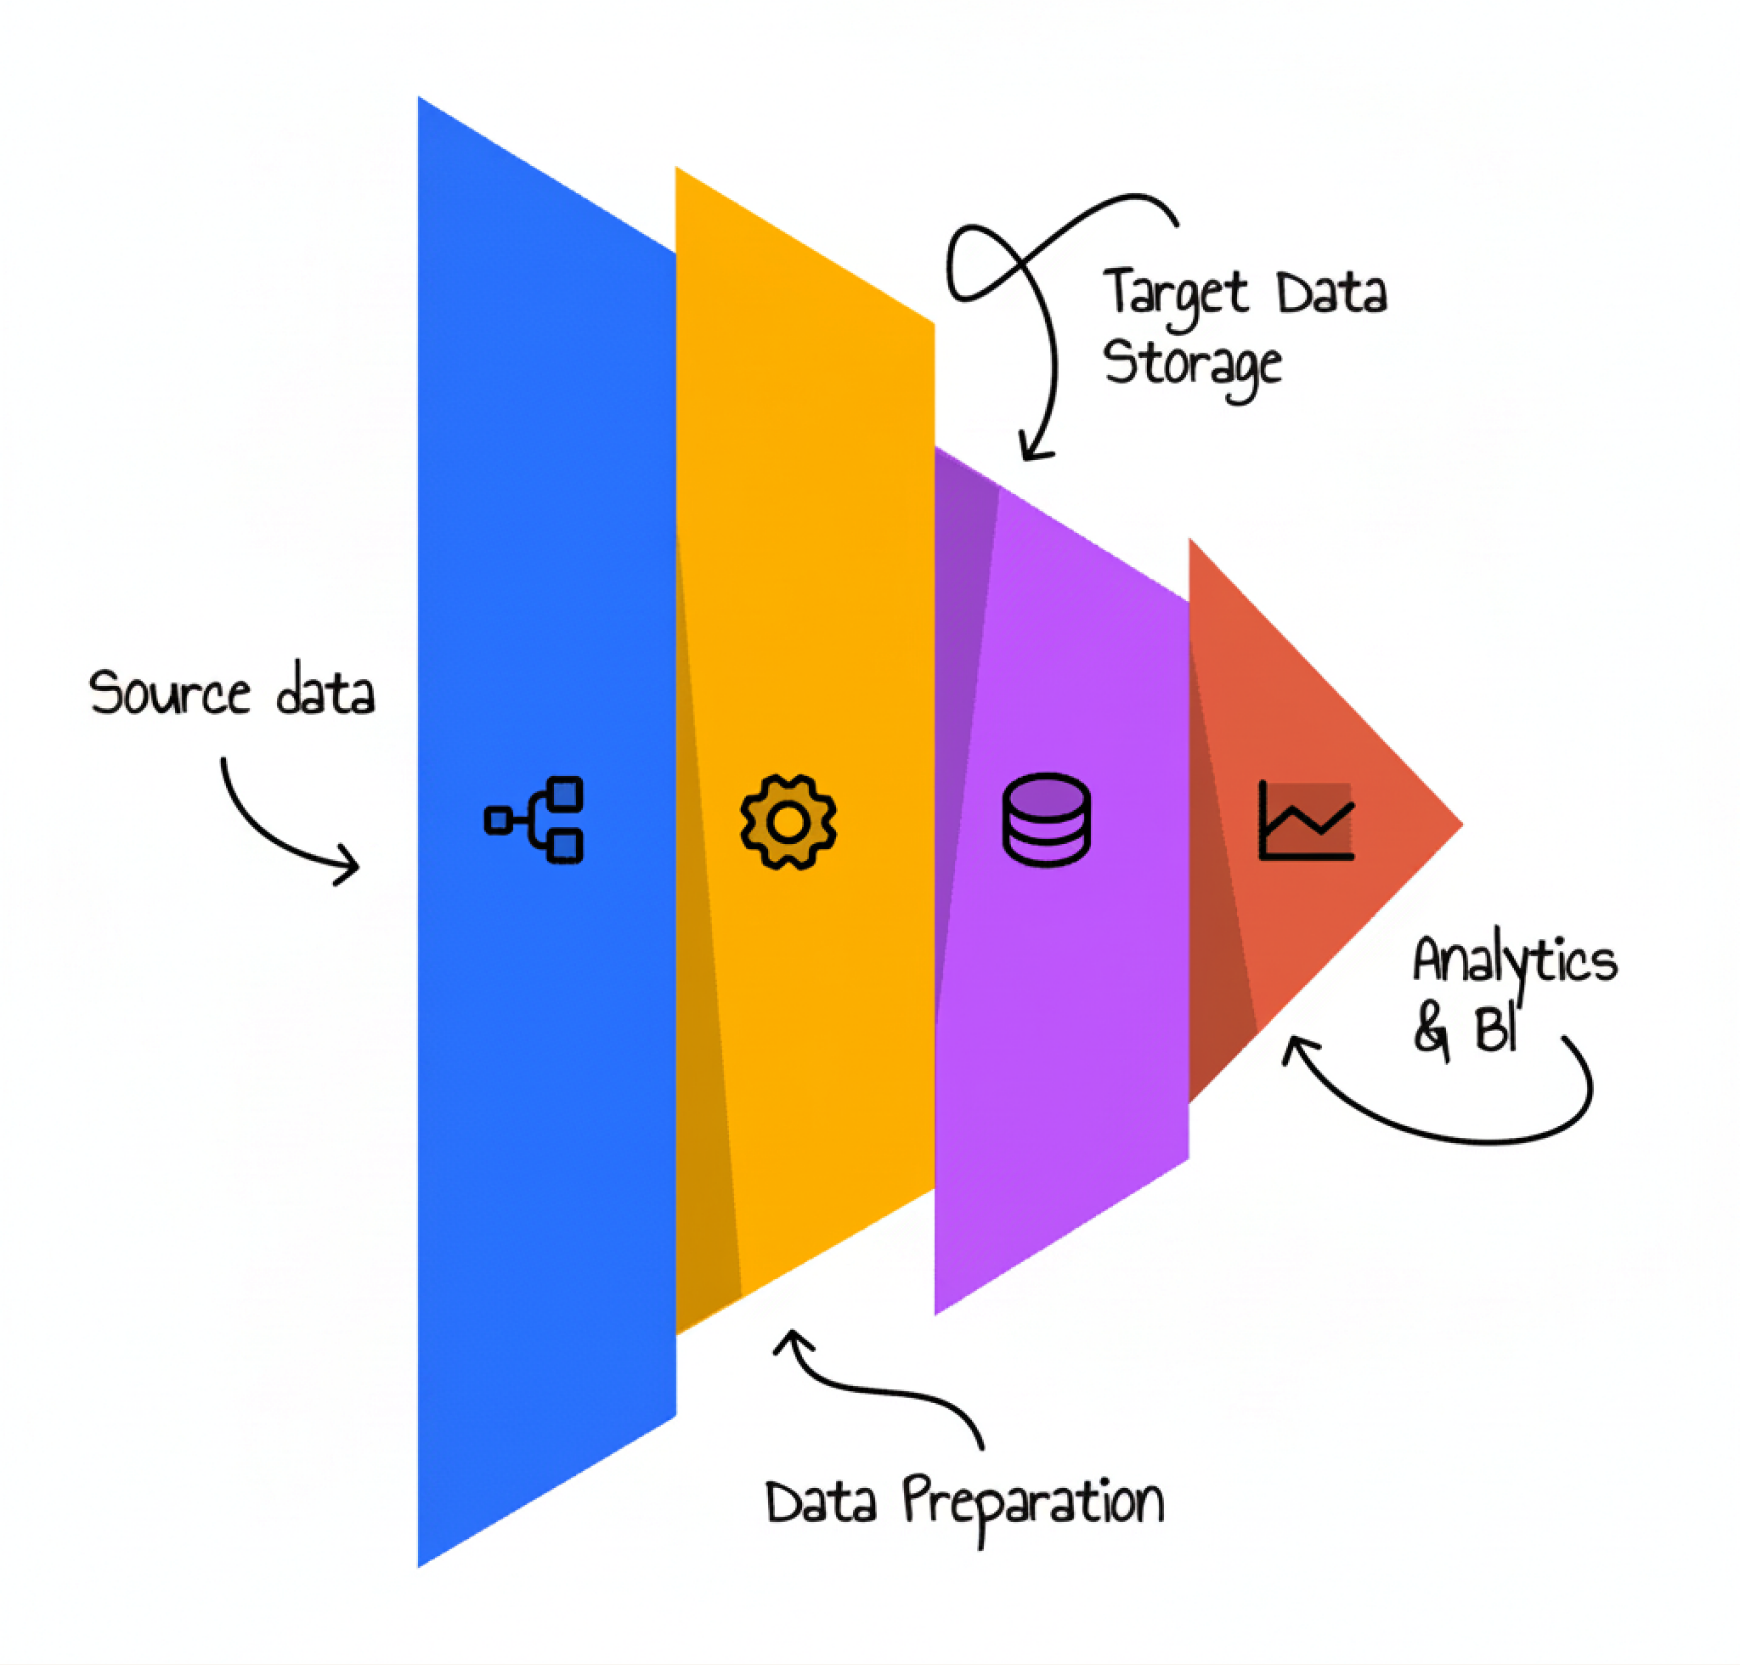
Inżynieria danych - pipeline danych, od zbierania danych ze źródeł po analizę
+800 organizacji powierza nam swoje projekty technologiczne i AI
[Nasze specjalizacje]

Przykłady zastosowań

Podłączamy Twoje źródła, automatyzujemy ich przetwarzanie i zbieramy je w hurtowni danych skalowanej pod Twoje obciążenie - ze stałym monitoringiem jakości.
Konsolidacja rozproszonych źródeł

Konsolidacja rozproszonych źródeł

Dane rozrzucone między ERP, CRM i plikami, których nikt ze sobą nie zestawia, trafiają do jednej hurtowni - w tych samych formatach, z tymi samymi definicjami, do odpytania jednym zapytaniem
Wykorzystanie uśpionych danych historycznych

Wykorzystanie uśpionych danych historycznych

Historia gromadzona latami staje się bazą, którą można przeszukiwać i która wraca do ludzi - zarówno do tych, którzy podejmują decyzje, jak i do tych, którzy tworzą dane, a nigdy nie widzą efektu
Dostęp do danych dla Twoich zespołów biznesowych

Dostęp do danych dla Twoich zespołów biznesowych

Twoje zespoły zadają pytania do danych zwykłym językiem i same przygotowują zestawienia - dzięki słownikowi, który opisuje Twoje wskaźniki językiem Twoich działów
Zasilanie Twoich modeli i agentów AI

Zasilanie Twoich modeli i agentów AI

Twoje modele predykcyjne i agenci AI pracują na sprawdzonych, kompletnych i aktualnych danych - a od tego bezpośrednio zależy jakość ich wyników
Raportowanie kontraktowe i regulacyjne

Raportowanie kontraktowe i regulacyjne

Każdą liczbę, którą publikujesz, prześledzisz aż do źródła - z historią przekształceń, przez które przeszła, i kontrolą tego, kto ma prawo ją oglądać
[Realizacje]

Trzy aplikacje oparte na danych, które działają u naszych klientów

motoryzacja
Stellantis

Połączenie sześciu źródeł danych, żeby katalog pojazdów dało się przeszukiwać w języku naturalnym

Spoticar, marka samochodów używanych grupy Stellantis, prowadzi sieć dealerów i portal ogłoszeń, który przyprowadza do nich kupujących. Informacje, od których zależy decyzja o zakupie, były rozproszone w sześciu systemach, które ze sobą nie rozmawiały: stan magazynowy, serwis, dokumentacja producenta, opinie klientów i historia wyszukiwań. Połączyliśmy je w jednej bazie grupy - w ramach jej procesu zasilania danych i zasad bezpieczeństwa - a potem zbudowaliśmy słownik, który opisuje te dane językiem branży. Kupujący zadaje pytanie po francusku i dostaje pasujące pojazdy, a dealer zarządza swoim stanem magazynowym - na tych samych danych.
+100 000pojazdów w katalogu
6systemów w jednej bazie
2interfejsy zasilane z tej samej bazy
Stellantis Logo
FEDERACJA SPORTOWA
Fédération Française d'Athlétisme

Wykorzystanie dwudziestu lat wyników biegów, żeby udostępnić je zawodnikom

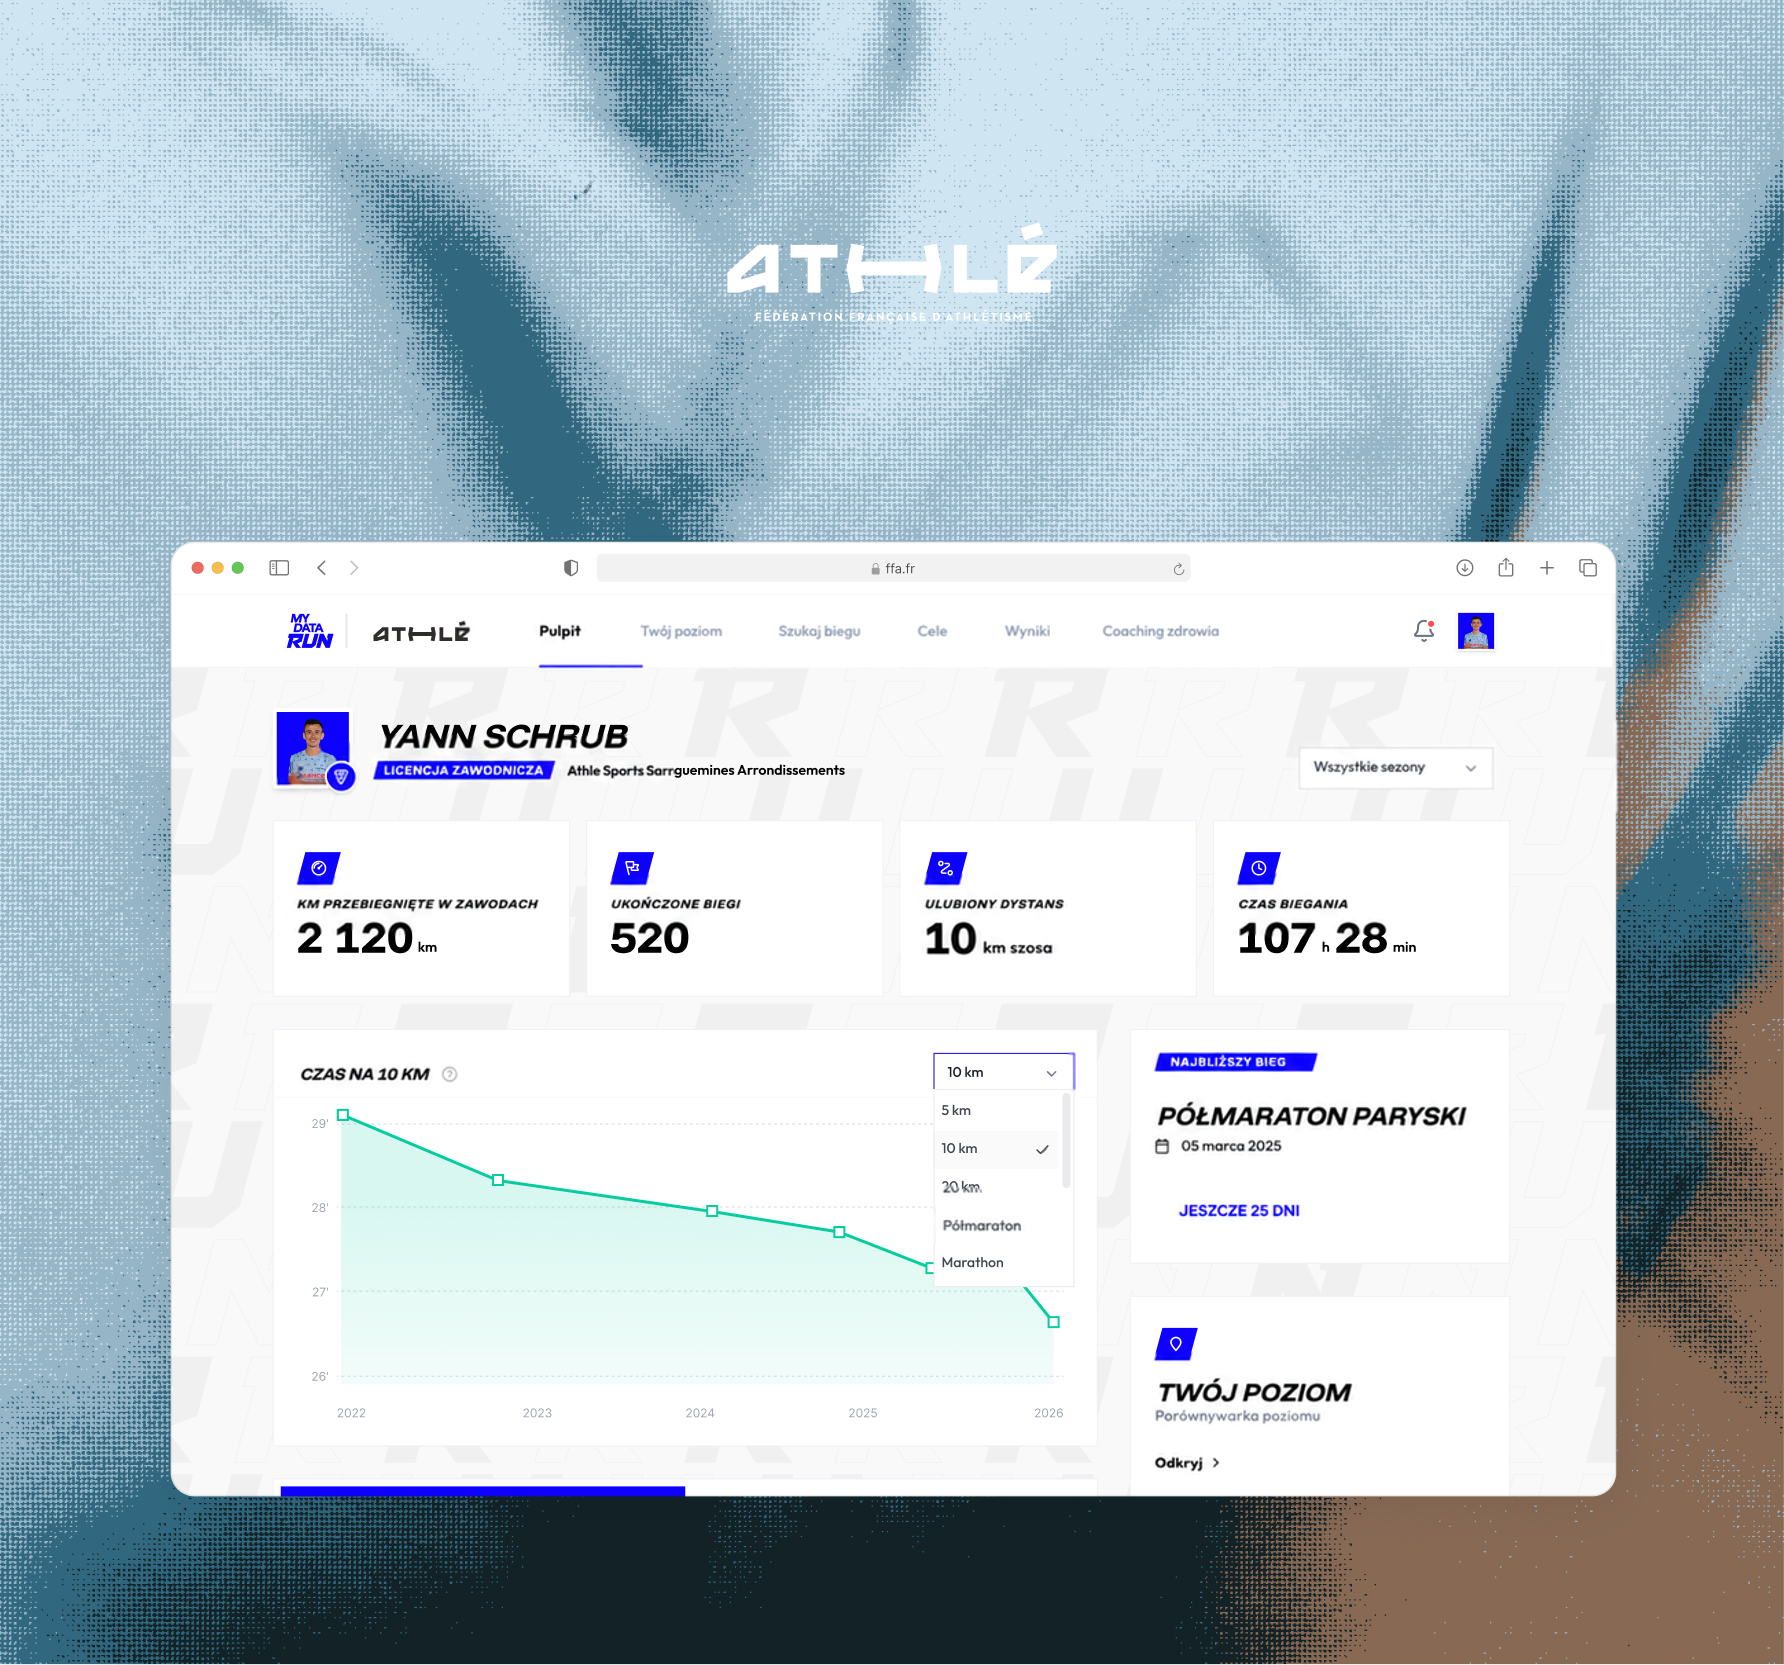
Fédération Française d'Athlétisme od ponad dwudziestu lat przechowuje oficjalne wyniki swoich zawodników - bez możliwości udostępnienia ich tym, którzy je osiągają. Zaprojektowaliśmy i zbudowaliśmy MyDataRun: platforma przejmuje całą tę historię, pozwala ją przeszukiwać i pokazuje ją w formie wykresów postępów. Każdy biegacz śledzi swoje wyniki, wyznacza sobie cele i porównuje się z najlepszymi zawodnikami we Francji - na stronach, które ładują się w mniej niż 300 milisekund, mimo że ogromny wolumen danych jest przeliczany na żądanie.
+60 mlnprzetworzonych wyników
1,2 mlnużytkowników
<300 msna obliczenia i wyświetlenie
Fédération Française d'Athlétisme Logo
BADANIA AGRONOMICZNE
Secobra

Odpytywanie baz danych rolniczych, żeby wybierać najlepsze odmiany

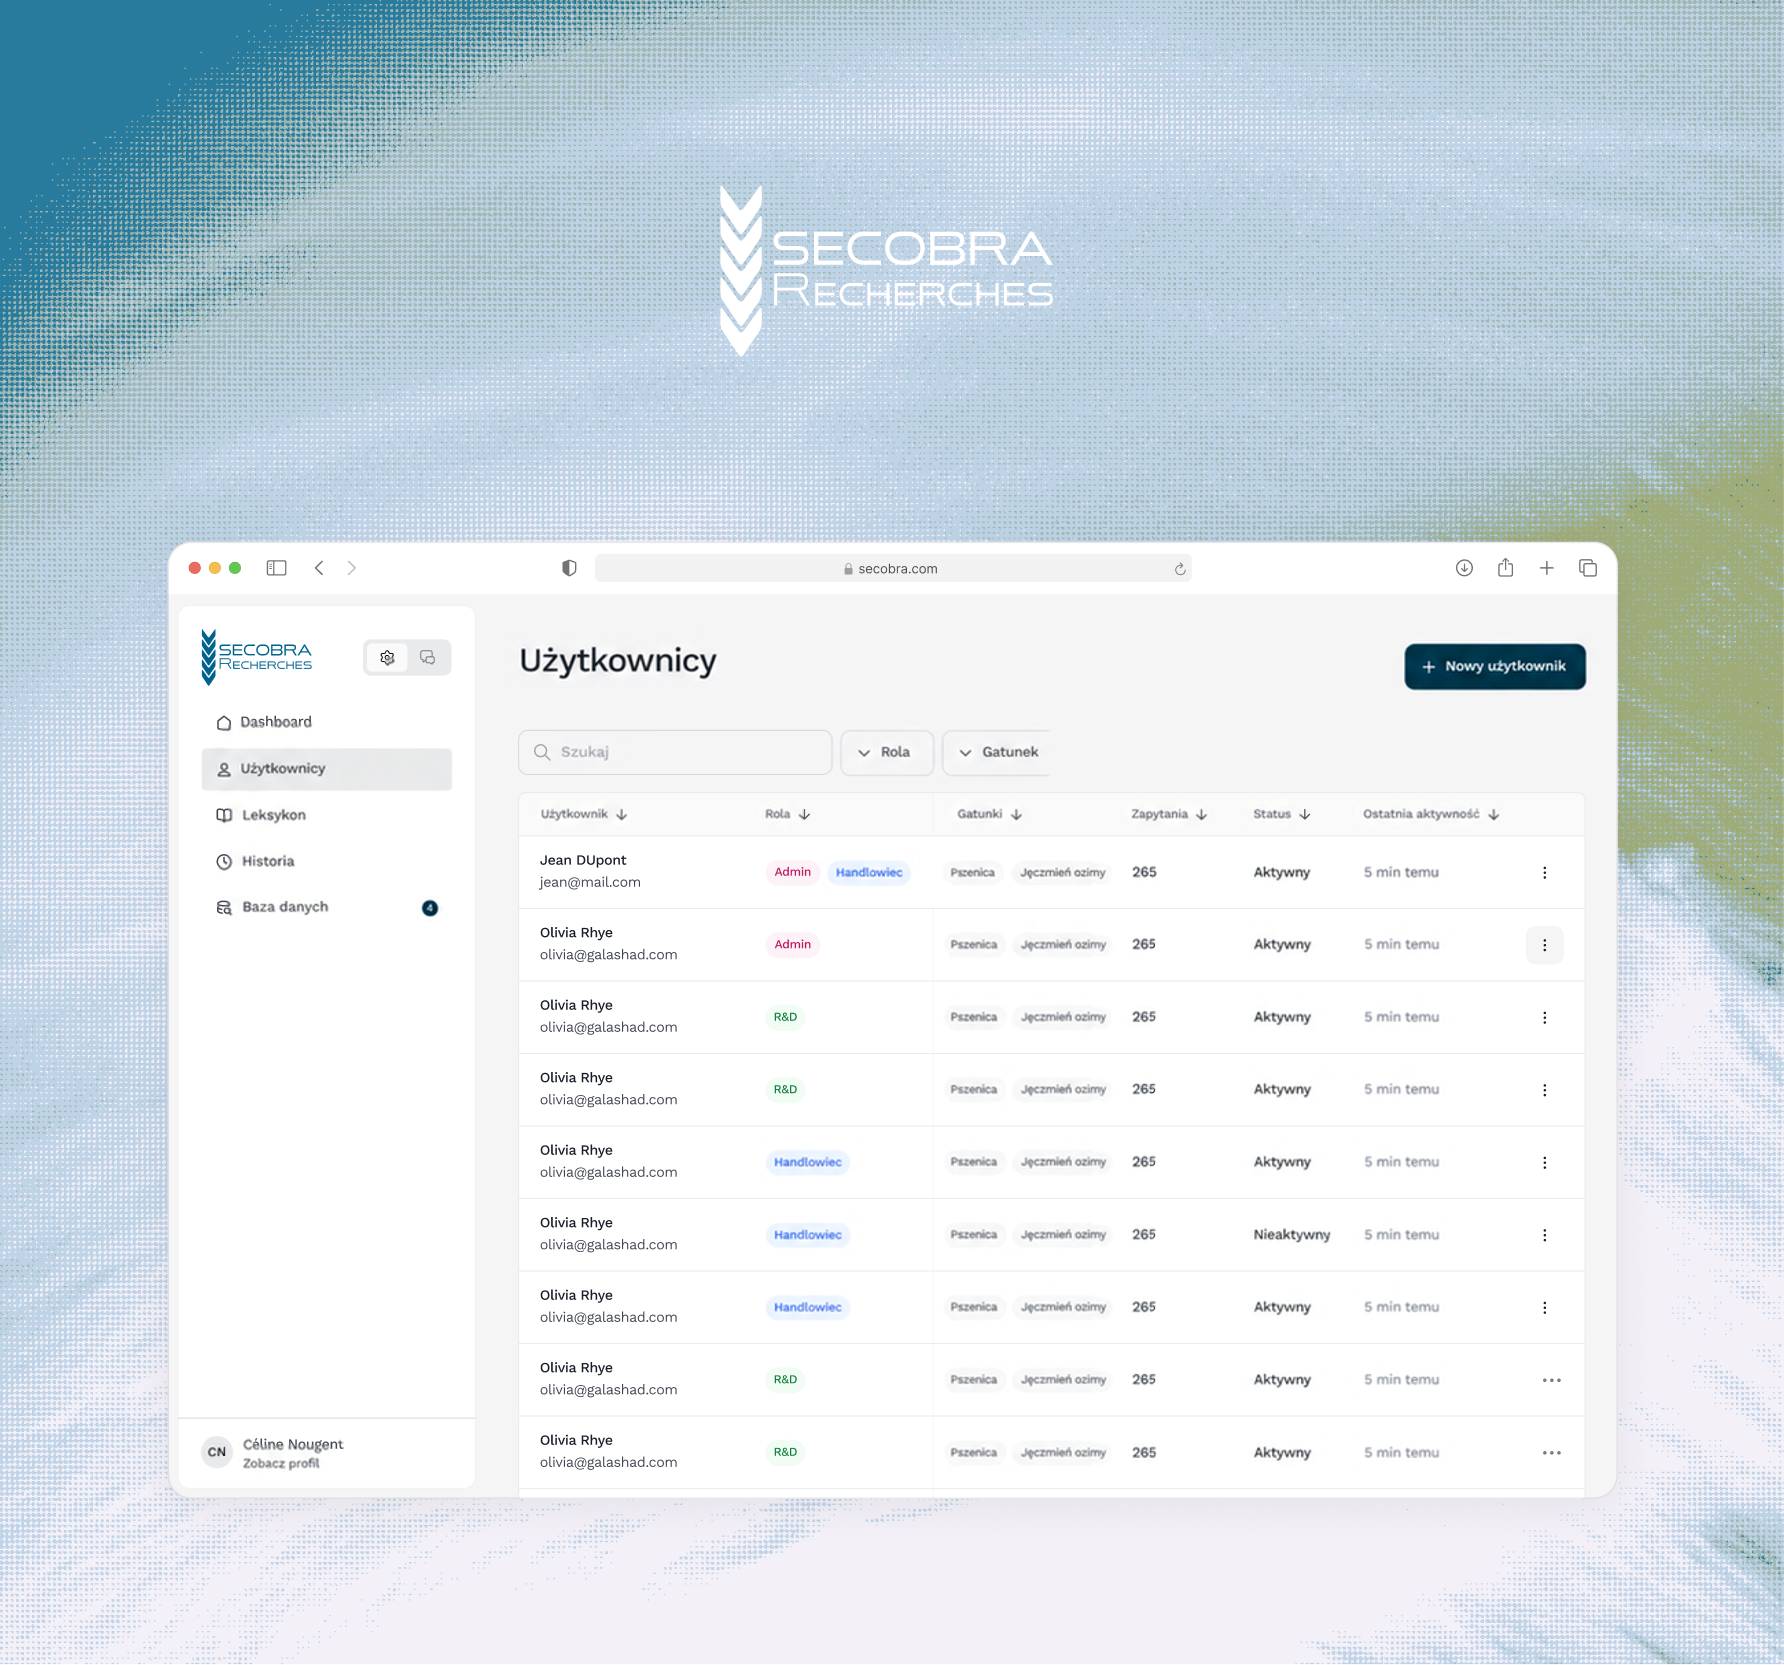
Secobra Recherches prowadzi prace nad hodowlą nowych odmian na dużych wolumenach danych rolniczych, genetycznych, meteorologicznych i handlowych. Badacze i handlowcy potrzebowali kogoś z zewnątrz, żeby sformułować zapytania, a eksport do arkusza kalkulacyjnego miał swoje limity - zarówno objętości, jak i czasu obliczeń. Dostarczyliśmy interfejs konwersacyjny, który odpytuje te bazy: silnik text-to-SQL obsługuje dane wewnętrzne, silnik dokumentowy korzysta ze źródeł publicznych, a narzędzie od razu zwraca odpowiedzi, tabele, wykresy i eksporty - w modelu hostingu wybranym przez firmę Secobra.
+10 000zapytań miesięcznie
30 sczasu odpowiedzi
Secobra Logo
[Nasza metoda]

Jak doprowadzamy fundament danych do produkcji

  • Zakres
    Etap 01

    Docelowe zastosowania i mapa Twoich źródeł

    Zaczynamy od decyzji i produktów, którym mają służyć dane. Potem mapujemy Twoje źródła - ich zakres historyczny i wiarygodność. Na tej podstawie ustalamy, co trafia do bazy i w jakiej kolejności.
  • ZBIERANIE
    Etap 02

    Podłączenie do Twoich źródeł wewnętrznych i zewnętrznych

    Wdrażamy mechanizmy zbierania danych dopasowane do każdego źródła - API, serwerów plików, strumieni czy baz danych - i wyposażamy je w alerty, które sygnalizują zmianę, zanim zepsuje ona przetwarzanie.
  • transformacja
    Etap 03

    Czyszczenie, normalizacja i modelowanie

    Automatyzujemy przetwarzanie, dzięki któremu Twoje dane da się ze sobą porównywać - z testami automatycznymi na każdym etapie. To samo pojęcie biznesowe ma wtedy tę samą wartość w każdym systemie.
  • JEDNA BAZA
    Etap 04

    Ustrukturyzowane przechowywanie, skalowane pod obciążenie

    Dzielimy Twoją bazę danych na warstwy i domeny biznesowe i skalujemy ją zarówno pod bieżący wolumen, jak i pod szczyty. Koszty działania mierzymy i kontrolujemy od pierwszego dnia pracy systemu.
  • integracja
    Etap 05

    Udostępnienie danych w Twoich narzędziach i modelach

    Podłączamy bazę do narzędzi, z których Twoje zespoły już korzystają - dashboardów, oprogramowania biznesowego czy modeli AI - bezpiecznie, niezawodnie i spójnie z Twoją obecną architekturą IT. Twoje zespoły mają dane pod ręką, w swoich aplikacjach.
  • utrzymanie
    Etap 06

    Monitoring jakości i aktualności danych

    Stale monitorujemy aktualność i spójność danych, a pipeline'y rozwijamy, gdy zmieniają się Twoje źródła albo sposób korzystania z danych.
01/06
[Dlaczego Galadrim?]

Dlaczego firmy powierzają nam projekty związane z danymi?

Sprawdzone doświadczenie

800+ klientów, 170+ ekspertów i 9 lat doświadczenia w budowaniu produktów AI - z fundamentami danych działającymi w przemyśle, sektorze publicznym i instytucjach badawczych.

Wszystkie Twoje źródła podłączone i uporządkowane

Podłączamy źródła, których nikt nie chce ruszać - API, serwery plików, strumienie XML, arkusze kalkulacyjne czy stare bazy danych - i monitorujemy je, żeby wychwycić zmianę, zanim zepsuje przetwarzanie.

Fundament, który wpina się w Twój stos technologiczny

Nasi inżynierowie pracują na Twoich obecnych bazach danych i narzędziach do orkiestracji, jeśli już je masz, i trzymają się Twoich konwencji oraz wewnętrznych procesów akceptacji. Zachowujesz to, co już działa, i zyskujesz przetwarzanie, którego Ci brakowało.

Dane, z których faktycznie korzystają Twoje zespoły

Opisujemy Twoje dane językiem Twoich zespołów. Dzięki temu mogą o nie pytać w języku naturalnym, a Twoi agenci AI korzystają z nich bez błędów interpretacji.

Jakość pod kontrolą także po wdrożeniu

Każdy pipeline ma własne testy automatyczne i monitoring aktualności danych. Twoje zespoły widzą stan każdego przepływu i dostają alert, zanim problem zauważą użytkownicy.

Zrealizujmy Twój projekt razem

Skontaktuj się z nami
[FAQ]

Najczęstsze pytania naszych klientów

Dostęp do Twoich źródeł w formacie, w jakim już istnieją, i osobę po stronie biznesu, która powie nam, co każda dana oznacza w Twojej firmie. Resztą zajmujemy się my: mapowaniem źródeł, migracją danych historycznych i przetwarzaniem dopasowanym do Twoich potrzeb.
Jeśli masz już hurtownię danych i narzędzia do orkiestracji, pracujemy w nich i trzymamy się Twoich konwencji. Nowy fundament proponujemy wtedy, gdy wychodzi taniej niż utrzymanie obecnego.
Mechanizmy zbierania danych wykrywają zmianę struktury albo zatrzymanie przepływu, zanim dashboard pokaże błędne dane. Poprawka jest częścią utrzymania.
Każdy pipeline wyposażamy w testy automatyczne i automatyczne odświeżanie, zebrane na jednym ekranie monitoringu. Twoje zespoły widzą tam stan wszystkich przepływów i dostają alert, zanim problem zauważą użytkownicy.
Na Twojej własnej infrastrukturze albo u dostawcy hostingu, którego wybierzemy razem z Tobą - we Francji lub w Unii Europejskiej, w zależności od tego, jak wrażliwe są Twoje dane. Żadne dane nie wychodzą poza ramy bezpieczeństwa, które ustalisz.
Do Ciebie. Kod, pipeline'y, modele danych i dokumentacja należą do Ciebie po każdym etapie dostawy. Przeniesienie praw zapisujemy w umowie od samego początku.
Każdy projekt wyceniamy na podstawie zakresu i priorytetów. Opisz nam swoją sytuację - wrócimy do Ciebie w ciągu 24 godzin ze wstępną oceną.
[Kontakt]

Masz projekt?

Pracujemy z klientami każdego rodzaju, we wszystkich branżach. Niezależnie od tego, czy prowadzisz własną firmę, czy kierujesz dużą organizacją, dobierzemy zespół odpowiadający Twoim potrzebom.

Zaufało nam już ponad 800 firm

Twoje zapytanie

Odezwiemy się w ciągu godziny.